Ingestão do que já existe
Conectores para data lake, PostgreSQL, filas e arquivos, com carga inicial e incremental separadas e versionadas.
Ingestão incremental a partir do data lake e do PostgreSQL, entity resolution auditável, pipelines idempotentes e APIs de consulta com latência previsível, integradas ao seu motor de decisão.
Agendar diagnósticoCarregar um dump inicial é fácil. O que quebra projeto é o resto: capturar mudanças do data lake e do PostgreSQL sem duplicar entidade, resolver que quatro cadastros são a mesma pessoa, reprocessar sem derrubar a consulta e expor tudo isso numa API que o motor de decisão consiga chamar dentro do SLA.
O grafo vale o que o pipeline sustenta.
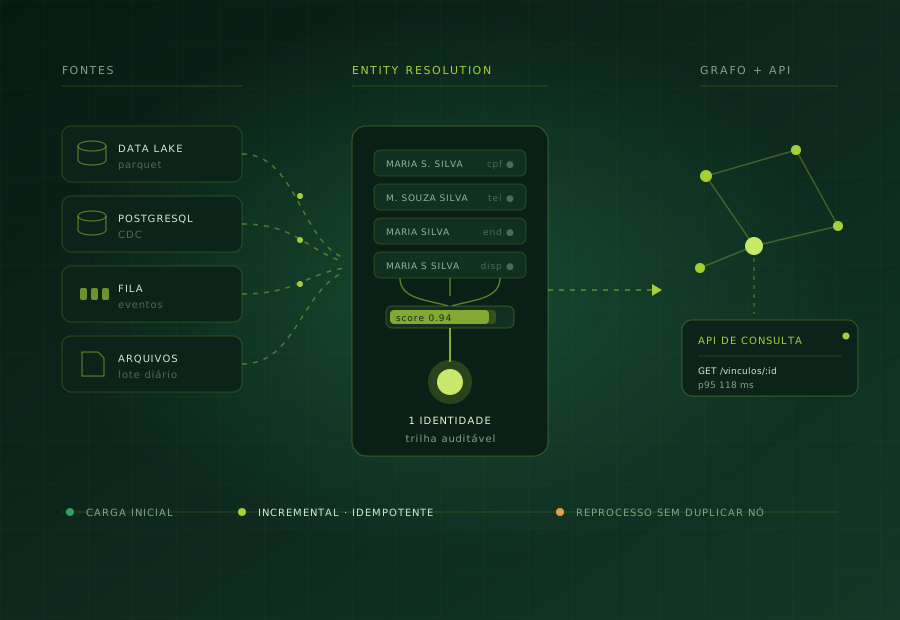
Construímos a esteira inteira: ingestão incremental a partir do data lake, do PostgreSQL, de filas e de arquivos; entity resolution com regras e score auditáveis; pipelines idempotentes e reprocessáveis; e APIs de consulta com latência previsível conectadas ao motor de decisão que você já usa.
Falar com um arquitetoCada item é definido antes de começar e entregue com documentação, para que a continuidade não dependa de nós.
Conectores para data lake, PostgreSQL, filas e arquivos, com carga inicial e incremental separadas e versionadas.
Casamento por documento, contato, endereço e dispositivo, com score, fila de revisão humana e trilha de por que dois cadastros viraram um.
Orquestração idempotente: reprocessar um dia, uma fonte ou a base inteira sem duplicar nó nem perder histórico.
Endpoints de consulta e de scoring por vínculo, versionados e plugados na esteira de decisão existente.
Duas horas com um arquiteto de grafos para revisar modelo, fontes, consultas e plataforma.